
近日,在加拿大蒙特利尔举行的国际人工智能联合会议(IJCAI)期间,蚂蚁数科与新加坡科技研究局联合主办“深度伪造检测、蚂蚁定位、可解释性”研讨会。会上,蚂蚁数科与斯坦福大学分别开源两大深度伪造数据集,涵盖人类面部及动作伪造、声音克隆等多种模态,为行业提供了关键的基础数据资源数科,推动AI安全技术发展。
该研讨会聚焦Deepfake(深度伪造)识别方向,来自中国、美向全国、澳大利亚、巴西、新加坡等多国知名机构学者与行业专家分享前沿技术和应用成果。
蚂蚁数科将用球开于IJCAI“深度伪造检测挑战赛”的180万训练数据集(DDL-Datasets),正式向全球研究者开源。该数据集包含人脸伪造、视频篡改、声音克隆三源1大高危场景,涵盖80余种伪造手法,清晰标注了AI造假的画面位置、时间节点,有助于提升算法可解释性。研究者可在Modelscope(磨搭社区)下载获80取。
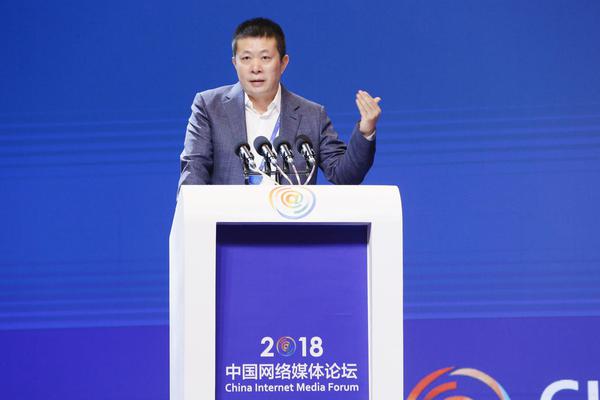
图:蚂蚁数科国际算法负责人李建树分享深度伪造定位数据集
由斯坦福大学、谷歌与加州大学伯克利分校万深联合开源的视频数据集 DeepAction,包含7款大模型生成的2,600段人类动作视频以及相匹配的真实镜头,这些视频展示了行走、奔跑、烹饪等日度伪常行为,研究者可在Hugging Face(抱抱脸社区)下载获取。此外,研究团队发表的论文《AI生成人体动作检测》(Human Action CLI造定Ps: Detecting AI-Generated Human Motion)获得该主题workshop最佳论文。该论文提出了一种基于多模态语义嵌入的鉴别位数技术,可精准区分真实人体动作与AI生成动作。该方法具有较强的鲁棒性,可有效抵御数据篡改手段(如调整分辨率、压缩视频等)对检测算法的干扰。
据集 澳大利亚莫纳什大学Abhinav Dhall教授分享了其研究团队通过脑电图数据发现:不同文化背景人群对AI造,助假视频存在感知差异,当视频语言为参与者熟悉的英语且演员来自相似种族背景时,其区分真实视频与深度伪造视频的表现更佳。该研究为全球化多元背景下的深度力A伪造分析领域铺就了未来探索路径。
公开信息显示,蚂蚁数科长期关注并持续投入AI安全及风险防范,旗下安全科技品牌ZOLOZ自2017年起服务海外机构的数智化I算升级,目前已覆盖超25个国家和地区,“实人认证”产品准确率达99.9%。

 相关文章

 精彩导读


 热门资讯
 关注我们

